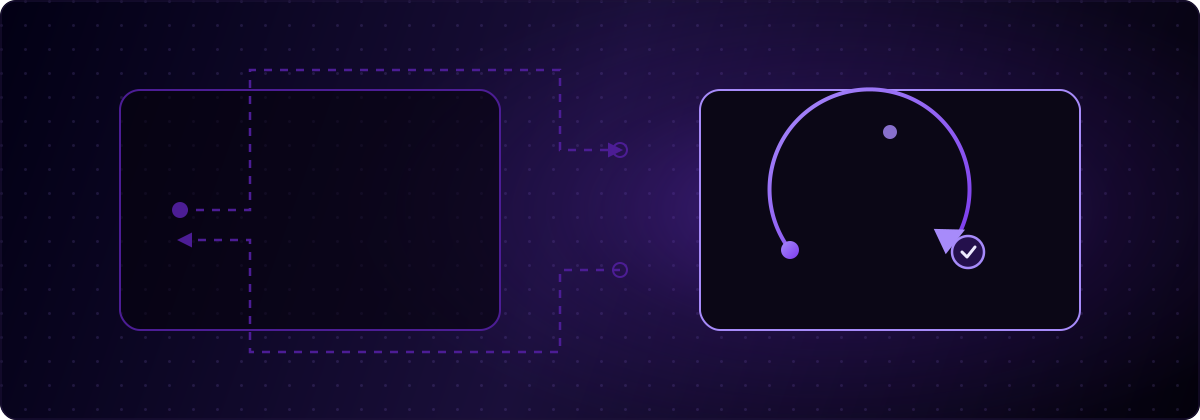
Lokalisierung verlagert sich stromaufwärts, weil die Kernannahme der alten Pipeline zerbrochen ist: dass sich Code langsam genug ändert, um einen stabilen String-Katalog zu exportieren, ihn woanders zu übersetzen und die Ergebnisse vor dem nächsten Release zu importieren. KI-Coding-Agents haben diese Annahme zunichtegemacht. globalize.now ist KI-gestützte Lokalisierungsinfrastruktur für die neue Position: Lokalisierung, die im Entwicklungsprozess läuft und als Pull Request ausgeliefert wird. Dieser Essay handelt davon, warum sich die Position verändert hat – nicht die Übersetzungsqualität.
Was bedeutet es, Lokalisierung stromaufwärts zu verlagern?
Es bedeutet, dass die Arbeitseinheit der Lokalisierung nicht mehr ein String-Katalog ist, sondern ein Commit. Im alten Modell beginnt Lokalisierung, nachdem der Code fertig ist. Im vorgelagerten Modell passiert sie dort, wo der Code lebt, in dem Moment, in dem sich der Code ändert, und ihr Ergebnis ist Code: ein lokalisierter PR, den du diffst, prüfst und mergest.
So sehen die beiden Pipelines aus.
Traditional:   build → internationalize → export → translate → review → import → ship

Upstream:      code → push → localized PR → merge → ship
Die erste Pipeline hat sieben Stufen und verlässt das Repository zweimal. Die zweite hat fünf, und keine davon verlässt das Repo. Dieser strukturelle Unterschied, nicht irgendein einzelnes Feature, ist das Thema dieses Essays.
Wie funktioniert die klassische Lokalisierungs-Pipeline?
Es funktioniert als Rundlauf, und jeder Pfeil darin ist eine Warteschlange. Du baust das Feature. Du internationalisierst es, extrahierst Strings in Keys — vorausgesetzt, dein Team oder dein KI-Agent hat von Anfang an strukturierten Code erzeugt. Du exportierst den Katalog auf eine Übersetzungsplattform. Übersetzer:innen oder maschinelle Übersetzung verarbeiten ihn. Jemand reviewt. Du importierst die Ergebnisse, löst die Konflikte, die sich angesammelt haben, während der Katalog veraltet war, und releasest.
Jede Übergabe existiert, weil die Arbeit an einem anderen Ort stattfindet, von anderen Personen verantwortet wird, nach einer anderen Uhr. Das war ein vernünftiges Design, als Releases vierteljährlich erschienen und sich Strings in Stapeln änderten. Die versteckte Abhängigkeit der Pipeline ist Stabilität: Der Katalog muss lange genug stillhalten, damit der Hin-und-Rückweg gelingt.
Er hält nicht mehr still. Im DORA 2025 State of AI-Assisted Software Development Report gaben 90 % der Software-Profis an, KI-Tools bei der Arbeit einzusetzen, und die Q4-2025-Impact-Studie von DX maß KI-verfassten Code mit 22 % des gemergten Codes beim durchschnittlichen erfassten Unternehmen. Code, der früher wöchentlich geändert wurde, ändert sich jetzt zwischen Mittagessen und Standup.
Wie sieht Lokalisierung innerhalb des Dev-Loops aus?
Wie jede andere automatisierte Prüfung, die bei jedem Push läuft. Du konvertierst die Codebase einmal: Strings extrahiert, Keys generiert, Übersetzungsdateien erstellt, Runtime-Anbindung vorhanden. Danach läuft der Sync bei jedem Push. Führt ein Commit neue Strings ein, kommen die Übersetzungen als Pull Request gegen deinen Branch zurück, in deinem Repository, strukturiert wie der Rest der App.
Das ist kein hypothetischer Durchsatz. In einem Lauf, den wir im August 2026 auf einem Demo-Repo aufgezeichnet haben, kam ein gepushter Commit als lokalisierter PR zurück, der 30 Übersetzungseinheiten in Deutsch, Französisch und Spanisch abdeckte – in 49 Sekunden. Unter einer Minute, vom Commit zum prüfbaren PR, ohne Menschen im Loop bis zur Review. Vergleiche das mit jeder Pipeline, in der das Wort „Export“ vorkommt.
Die einmalige Konvertierung ist, um es klar zu sagen, nicht sofort erledigt. Bei echten Apps dauert sie etwa 30 Minuten, weil dabei Code umstrukturiert wird: Strings extrahieren, Keys generieren, eine Runtime anbinden. Das ist die Tür. Der Loop bei jedem darauffolgenden Push ist das eigentliche Produkt.
Die entscheidende Eigenschaft dieses Loops ist nicht die Geschwindigkeit. Es ist, dass nichts das Repo verlässt. Es gibt keinen Katalog, der auf einer externen Plattform liegt und sich langsam von main entfernt. Der Monorepo-Lauf, den wir zuvor veröffentlicht haben zeigte die einmalige Konvertierung in großem Maßstab; der Loop ist es, der das Ergebnis danach am Leben hält. Mergen oder schließen – dieselben zwei Verben, die jede andere Änderung regeln. Wenn du bereits so arbeitest, zeigt dir die Entwicklerdokumentation das Setup.
Warum erzwingen KI-Coding-Agents diesen Wandel?
Weil sie den Engpass verschoben haben. Der begrenzende Faktor in der Lokalisierung war früher die Übersetzungskapazität: wie schnell ein Anbieter oder eine Engine einen gut strukturierten Katalog verarbeiten konnte. Agents generieren weit über diesen Engpass hinaus und schaffen einen neuen, der davorliegt. Die knappe Ressource ist jetzt architektonische Konsistenz nach der Generierung – Keys einheitlich halten, Übersetzungsdateien vollständig, Struktur intakt, während ein Agent täglich UI zur Codebase hinzufügt.
Ein Agent, der um eine Checkout-Seite gebeten wird, liefert eine funktionierende Checkout-Seite mit hartcodierten Strings direkt im JSX. Wir haben die Anatomie davon in AI code broke localization beschrieben: Ein analysiertes React-Projekt enthielt 1.284 UI-Strings über 312 Dateien hinweg, ganz ohne i18n-Struktur. Den Katalog, den die klassische Pipeline exportieren möchte, gibt es in dieser Codebase schlicht nicht. Und morgen sieht die Codebase schon wieder anders aus, weil der Agent weiter releast.
Eine nachgelagerte Pipeline trifft auf diese Realität permanent im Hintertreffen. Was auch immer sie exportiert hat, ist zum Zeitpunkt des Imports bereits veraltet. Die einzige Position, aus der Lokalisierung mit generiertem Code Schritt halten kann, ist innerhalb des Loops, der ihn erzeugt – und das gilt unabhängig davon, ob der Code von Cursor, Claude Code oder Lovable stammt.
Ist KI-Übersetzung nicht dasselbe?
Nein, und genau hier geht die Marktdebatte in die Irre. Lokalise bezeichnet sich selbst als KI-Lokalisierungsplattform; Phrase liefert Language AI für maschinelle Übersetzung im großen Maßstab. Beides sind reale Fähigkeiten. Beide beschleunigen einen einzelnen Pfeil in der alten Pipeline: den Übersetzungsschritt. Der Katalog wird weiterhin exportiert, lebt weiterhin auf einer externen Plattform, kommt weiterhin über einen Import zurück.
Ein schnellerer Pfeil in einem siebenstufigen Hin-und-Rückweg ist eine Optimierung. Den Hin-und-Rückweg abzuschaffen ist ein anderes Produkt. Das ist die eigentliche Schichten-Unterscheidung: Plattformen, die um Übersetzer-Workflows herum gebaut sind, besetzen die Management-Schicht, und globalize.now besetzt die Infrastrukturschicht darunter, generiert die Keys und Übersetzungsdateien direkt aus dem Code, im Repo. „KI-gestützt“ beschreibt beides. Es unterscheidet keins von beiden. Die Position schon.
Was gehört weiterhin stromabwärts?
Menschliches Urteilsvermögen bei Copy mit hohem Risiko. Rechtstexte, regulierte Aussagen, Markenstimme in einem Markt, der dir wichtig ist: Das verdient eine:n professionelle:n Übersetzer:in und einen Review-Durchgang, und Teams mit diesem Bedarf werden weiterhin Tools nutzen, die um Übersetzer-Workflows herum gebaut sind. Nichts an vorgelagerter Lokalisierung verhindert das; der lokalisierte PR ist eine reviewbare Fläche, und ein Mensch kann ihn vor dem Merge an jedem beliebigen Standard messen.
Was endet, ist die Ära, in der jedes Team eine Übersetzer-Workflow-Plattform übernehmen musste, nur um eine zweite Sprache auszuliefern. Ein Solo-Entwickler mit einem KI-gebauten Produkt hat keine Übersetzer:innen zu verwalten. Er hat Commits. Das Tooling sollte ihn genau dort abholen.
Der Loop ist das Produkt
Wenn dein Code über Pull Requests ausgeliefert wird, sollten es deine Übersetzungen auch. globalize.now konvertiert die Codebase einmal und hält sie danach bei jedem Push aktuell — PR rein, PR gemerged, released.
globalize.now konvertiert hartcodierte App-Texte in übersetzungsreife Locale-Dateien und hält sie aktuell, während Sie veröffentlichen.
Probiere globalize.now kostenlos