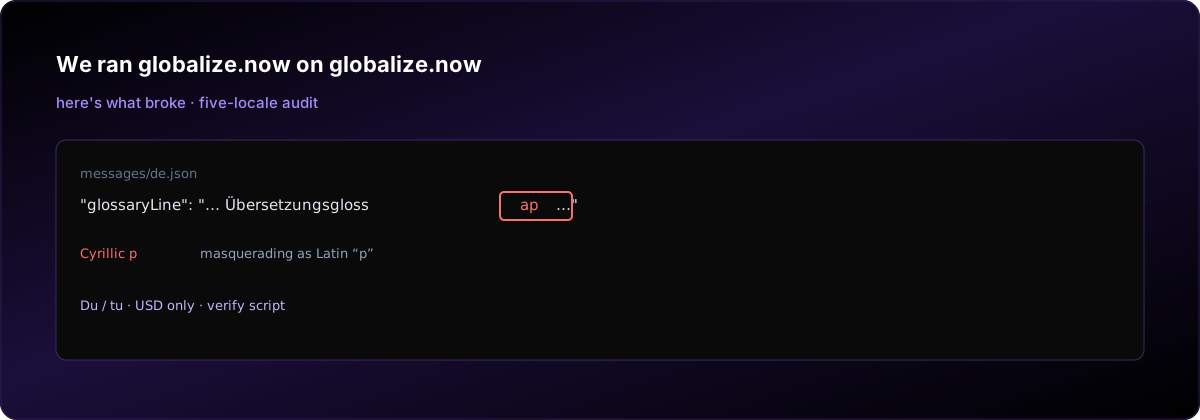
Wir verkaufen Übersetzungsinfrastruktur. Unsere eigene Marketing-Site läuft in fünf Sprachen. Als wir das JSON geprüft haben, das wir tatsächlich ausliefern, war der erste Treffer kein Ton-Problem. Es war ein einzelnes falsches Zeichen in einem deutschen Kompositum, das auf den ersten Blick fast korrekt aussah: ein kyrillischer Buchstabe, wo Lateinisch hingehört. Das Wort las sich wie ein Glossareintrag, bis man sich den Code-Point genauer ansah. Wenn schon unsere eigenen Übersetzungen kaputt sind, warum sollte dann jemand dem Produkt vertrauen?
Fünf Fehler, die nie hätten released werden dürfen
Kyrillisch in deutschem UI-Text. Eine Glossarzeile enthielt einmal eine gemischte Schrift: Die Endung sah aus wie lateinisches „ar“, aber ein Buchstabe war es nicht. Muttersprachler:innen fällt das sofort auf. Der Rechtschreibprüfung nicht.
**The string:** …"Übersetzungsglossар"… (Cyrillic "р" in the compound)
**What it should be:** "Übersetzungsglossar"
**Why it matters:** It reads as corrupted text. It signals automated output nobody proofread in the target language.
Register-Umkehr zwischen Deutsch und Französisch. Die Site ist ein Entwickler-Tool. Der Ton sollte dem entsprechen, wie Engineers tatsächlich in Produkt-UIs schreiben. Wir hatten überall in de und fr die formelle Anrede ausgeliefert. Das ist keine Kleinigkeit. Es bedeutet, dass der Standard-Übersetzungspfad für die gesamte Oberfläche das falsche Register gewählt hat — nicht nur für ein paar Randfälle.
**The string:** "… wie Sie …" / "vous pouvez …"
**What it should be:** informal "du" / "tu" voice for product and FAQ
**Why it matters:** Every screen sounded like enterprise procurement, not like the product we sell to vibe coders.
Erfundene Währung. Im Englischen standen Dollar. Im Deutschen erschienen Euro mit einer monatlichen Bezeichnung. Wir berechnen keinen unterschiedlichen Preis je Land. Das JSON legte das aber nahe.
**The string:** "20 €/Monat" (and similar) next to "$20/mo" elsewhere
**What it should be:** one USD amount, formatted per locale via code (e.g. Intl), not hand-invented symbols in JSON
**Why it matters:** Pricing trust. Mixed symbols read as either a bug or a hidden price change.
Falsche Freunde bei „coding“. In drei Sprachen wurde „coding environment“ mit dem Wort für Kodierung übersetzt. Die FAQ sagte den Leuten, sie könnten in ihrer „Kodierungsumgebung“ bleiben. Das ist bei jeder Lesart des Produkts falsch.
**The string:** Spanish "codificación", Italian "codifica", German "Codierung" in the wrong sense
**What it should be:** development environment wording (e.g. entorno de desarrollo / ambiente di sviluppo / Entwicklungsumgebung)
**Why it matters:** It is a semantic bug. It reads like we do not understand our own domain.
„Ship“ als Postversand gelesen. Deutsche und italienische Strings verwendeten Verben, die man mit Paketen verbindet, nicht mit dem Release von Software. Gleiche englische Quelle, falsches Wortfeld. Das kam von unkorrigierten maschinellen Vorschlägen, nicht von einer bewussten Stilentscheidung.
**The string:** parcel-shipping verbs applied to "ship your app"
**What it should be:** release / deploy / deliver software wording
**Why it matters:** Developer trust. One wrong verb tells the reader the copy was never read by a developer in that language.
Warum automatisch generierte Übersetzungen driften
Das ist keine Abrechnung mit Übersetzer:innen. Ein Großteil der Site hatte nie einen menschlichen Check pro String. Allzweck-Modelle greifen standardmäßig zum formellen Register, weil zweisprachiger Massentext im offenen Web nun mal so aussieht. Außerdem mischen sie schriftübergreifend Beinahe-Homographen, wenn das Ziel „plausible Zeichen“ ist, nicht „korrekte Schrift“. Ohne Glossar driftet die Wortwahl zwischen benachbarten Schlüsseln auseinander. Ohne Währungsregel erfindet das Modell plausibel klingende lokale Symbole. Ohne Domain-Checks kollidieren Encoding und Coding. Genau diesen Fehlermodus zu vermeiden, ist unser Job. Unsere eigene Site hat ihn trotzdem ausgeliefert – bis wir sie geprüft haben, wie es eine Kundin auch täte.
Was wir nach dem Cleanup gebaut haben
Einmalige Textkorrekturen sind kein System. Der dauerhafte Teil ist eine kleine Policy-Datei, die das gesamte Team (und jeder künftige automatische Übersetzungs-Batch) als Gesetz behandeln kann, plus ein Verifikationsskript, das wir vor jedem Merge laufen lassen können.
Policy. i18n/LOCALIZATION_POLICY.md hält das Register pro Locale fest, ausschließlich USD-Preise im JSON, Entscheidungen zu Lehnwörtern (zum Beispiel vibe coders im Englischen zu belassen), Regeln zu falschen Freunden bei Coding vs. Kodierung sowie Typografie für Inline-Literale. Das Ganze ist bewusst kurz gehalten. Steht eine Regel nicht schriftlich fest, wird ein Modell sie nicht konsistent ableiten.
## Currency
- USD only in all locales. Use {monthlyPrice} and {overageRate} placeholders…
## False friends
- Coding environment is not encoding: Spanish desarrollo / Italian sviluppo / German Entwicklung…
Verifikation. scripts/verify-translations.sh durchsucht die lateinischen Übersetzungsdateien nach kyrillischen Zeichen, Euro-Symbolen, den alten Falsche-Freunde-Substrings sowie nach Parität der Preis-Platzhalter gegenüber messages/en.json. Optionale Checks nutzen ripgrep, sofern installiert. Das Skript ist ein Boden, keine Decke. Es sorgt dafür, dass „wir haben es einmal repariert“ nicht beim nächsten Massen-Edit stillschweigend verfällt.
Code statt weiterer JSON-Ratereien. Wir haben angezeigte USD-Beträge in lib/pricing.ts zentralisiert und formatUsdPerMonth sowie formatUsdOveragePer1k in die Startseite und die FAQ eingebunden, damit Übersetzungsdateien keine Zahlen mehr erfinden. Der Bug waren nicht nur die falschen Strings. Der Bug war, dass Policy und Formatter vor der Skalierung noch nicht vorhanden waren.
Was du dir für deine eigene KI-gestützte i18n abschauen solltest
Wenn du Übersetzungen mit einem Modell generierst, ist das Register der Regler mit der größten Streuung. Lege ihn pro Locale fest, bevor du weitere Sprachen hinzufügst. Lege die Währung im Code fest, nicht in Fließtext. Lege Markennamen und Entwickler-Jargon fest. Lass automatisierte Checks laufen, die den Batch bei Fehlern stoppen, statt auf „das schauen wir uns später an“ zu setzen. Später passiert nie mit derselben Qualität wie beim ersten Durchgang.
Für die Architektur-Geschichte hinter diesem Audit lies How to Localize an AI-Generated App und den Tooling-Vergleich in globalize.now vs Lokalise vs Crowdin. Wenn du i18n in deinem eigenen Repo einrichtest und dieselben Leitplanken willst: Verbinde das Repository bei globalize.now, und die Konvertierung läuft einmal, direkt in der App; npx skills add globalize-now/globalize-skills ist der Einstiegspunkt, den wir für Skills dokumentieren, die sich neben deinem Code installieren. Der ehrliche Abschluss: Wir haben unser eigenes Dogfood gegessen, hässliche Bugs gefunden, die Policy geschrieben und ein Gate eingebaut. Das ist die Messlatte, die jeder mehrsprachige Launch erreichen sollte.
globalize.now konvertiert hartcodierte App-Texte in übersetzungsreife Locale-Dateien und hält sie aktuell, während Sie veröffentlichen.
Probiere globalize.now kostenlos