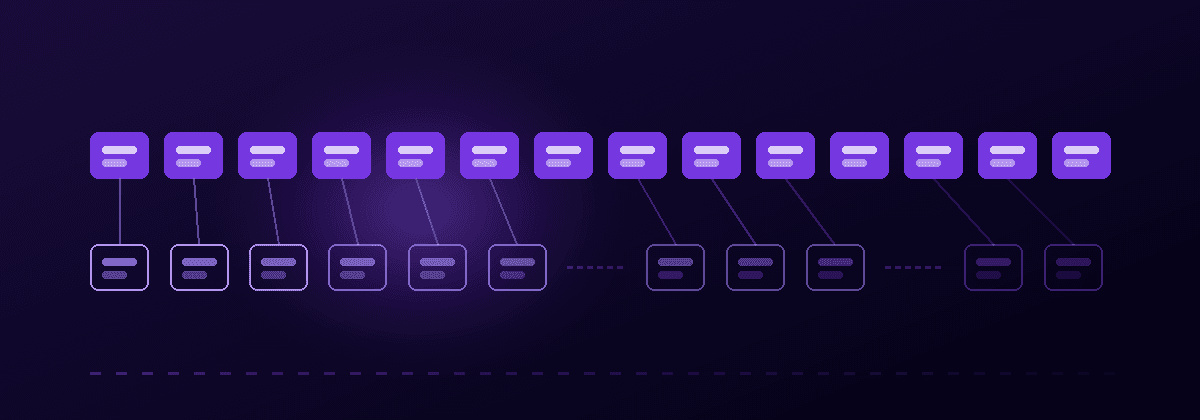
Translation files इसलिए drift करती हैं क्योंकि एक ही data का ownership दो systems के पास है और इनमें से कोई भी निर्णायक नहीं है। Developer के merge करने पर repository बदलती है। Translation files तब बदलती हैं जब किसी को उन्हें update करना याद आता है। ये अलग-अलग clocks हैं और इनके बीच का अंतर ही missing keys, orphaned keys और stale strings को जन्म देता है। globalize.now code लिखे जाने वाली जगह पर keys और locale files generate करके इस अंतर को बंद करने वाली AI-powered localization infrastructure है, इसलिए पीछे छूटने वाली कोई दूसरी clock नहीं रहती।
Locale files के sync से बाहर होने का असली कारण क्या है?
एक file लिखी जाती है और बाकी maintain की जाती हैं—और ये दोनों एक ही काम नहीं हैं।
किसी फ़ीचर पर काम कर रहा डेवलपर en.json में बदलाव करता है, क्योंकि स्ट्रिंग उसी फ़ाइल में जानी है। बाकी locales किसी और की समस्या हैं और किसी और के शेड्यूल पर हल होंगी। DEV पर इस पैटर्न के बारे में लिखने वाले एक डेवलपर ने इसकी दो विफलता-स्थितियाँ बताईं: keys अंग्रेज़ी फ़ाइल में जुड़ जाती हैं और बाकी फ़ाइलों में भुला दी जाती हैं, इसलिए ऐप का कुछ हिस्सा चुपचाप अंग्रेज़ी पर वापस चला जाता है; या किसी एक locale में keys हटा दी जाती हैं, लेकिन दूसरे में बनी रहती हैं, इसलिए बेकार entries जमा होती जाती हैं। दोनों मामलों में समस्या का पता चलने का तरीका एक ही है—कई हफ़्तों बाद ग्राहक की शिकायत।
इनमें से कोई भी translation की समस्या नहीं है। कुछ भी गलत अनुवादित नहीं हुआ। स्ट्रिंग्स को कभी कहीं भेजा ही नहीं गया।
यह वह failure mode है जो हर tooling upgrade के बाद भी बना रहता है, क्योंकि tooling उस जगह के downstream में बैठी होती है जहाँ स्ट्रिंग बनाई गई थी। अगर स्ट्रिंग pipeline में आई ही नहीं, तो बेहतर pipeline भी मदद नहीं करेगी। यही मूल कारण chain में इससे पहले भी दिखता है, जब कोडिंग एजेंट ऐसी स्ट्रिंग्स लिखता है जिन्हें कभी key बनाया ही नहीं गया।
locale files इतने merge conflicts क्यों पैदा करती हैं?
क्योंकि वे generated data हैं, जिन्हें हाथ से ऐसे format में संपादित किया जा रहा है जिसे मशीनों द्वारा लिखे जाने के लिए बनाया गया है।
locale file keys और strings का एक flat map होती है। दो branches में एक ही समय पर फ़ीचर जुड़ने पर दोनों उसी map में entries जोड़ती हैं—आमतौर पर लगभग एक ही जगह, अक्सर alphabetical क्रम के एक ही हिस्से में। Git को ऐसी फ़ाइल में पास-पास की दो lines में बदलाव दिखते हैं, लेकिन वह semantic structure नहीं समझता, इसलिए conflict सुलझाने का काम इंसान को सौंप देता है।
इसे सुलझाने वाला डेवलपर अक्सर target language पढ़ नहीं पाता। सुरक्षित तरीका दोनों पक्षों को रखना है—और इसी तरह duplicate keys आती हैं। तेज़ तरीका एक पक्ष रखना है—और इसी तरह translations चुपचाप हट जाती हैं।
कोई भी lockfile के conflicts हाथ से resolve नहीं करता। उसे regenerate किया जाता है। locale files को भी उसी तरह treat करना चाहिए, जैसे ही वे किसी व्यक्ति द्वारा लिखे जाने वाले documents नहीं रह जातीं।
review में पड़े-पड़े कोई translation कितना पुराना हो जाता है?
इतना कि वह product का वर्णन करना बंद कर दे—और इसे सार्वजनिक रूप से मापा जा सकता है।
DevOps.com पर प्रकाशित एक field report ने open-source projects के पाँच वास्तविक localization pull requests का अध्ययन किया। सबसे instructive उदाहरण Kilo Code PR #8377 है: automated checks सफल रहे, maintainer review बाद में आया, और तब तक repository के भीतर architecture बदल चुका था। PR बंद कर दिया गया और मौजूदा architecture के आधार पर दोबारा submit करने को कहा गया। उसी report में OpenClaw का एक issue भी दर्ज है, जहाँ volunteers ने Spanish, Japanese, Portuguese, Korean, Chinese और Vietnamese translations देने की पेशकश की, लेकिन maintainers ने कहा कि उन्हें शामिल करने का कोई तरीका उनके पास नहीं था।
इन्हें quality reports के बजाय latency reports की तरह पढ़िए। लिखे जाने के समय translations सही थीं। उनके queue में पड़े रहने के दौरान interface बदल गया।
Localization tools की तुलना करते समय यही वह लागत है जिसका कोई हिसाब नहीं लगाता। हर कोई translation को मापता है। लगभग कोई यह नहीं मापता कि कोई string transit में कितनी देर रहती है, या उसके गायब रहने के दौरान interface में क्या बदल गया।
वास्तव में round-trip की लागत कितनी है?
Translation से ज़्यादा coordination में—इसीलिए invoice कभी असली परेशानी नहीं बताता।
दिखने वाली लागत per word, per key या per seat होती है और महीने में एक बार bill पर दिखाई देती है। छिपी हुई लागत है—एक डेवलपर का यह पता लगाना कि “कौन-सी फ़ाइल edit करूँ”, दूसरे डेवलपर का ऐसी भाषा में conflict सुलझाना जिसे वह पढ़ नहीं सकता, तीसरे का यह देखना कि German build में ग्यारह keys गायब हैं, और मूल feature author से पाँच हफ़्ते पहले लिखी गई string के बारे में सवाल पूछना।
Pricing comparison में इनमें से कुछ भी दिखाई नहीं देता। फिर भी हर sprint में developer rates पर इन सबकी कीमत चुकाई जाती है। कम sticker price वाला ऐसा tool जो दो engineers का हफ़्ते में एक दिन ले ले, सस्ता नहीं है।
यही round-trip उस लागत को पैदा करता है। Strings जहाँ बनाई जाती हैं और जहाँ उनका translation होता है, उन दोनों जगहों के बीच files ले जाना सबसे महँगा चरण है—और आप इसे किसी से भी खरीदें, महँगा ही रहता है। इसी वजह से localization development loop में upstream आती जा रही है।
जब keys वहीं generate हों जहाँ code लिखा जाता है, तो क्या बदलता है?
दूसरी clock गायब हो जाती है और drift के लिए कोई जगह नहीं बचती।
Sequence अब यह नहीं रहती: डेवलपर hardcoded string लिखता है, कोई उसे बाद में ढूँढ़ता है, कोई key बनाता है, कोई file बाहर भेजता है, कोई translation करता है और कोई उसे वापस लाता है। अब sequence यह है: feature के उसी commit में string को value के साथ key के रूप में लिखा जाता है, और वहीं से translation आगे बढ़ता है।
globalize.now के साथ शुरुआत एक one-time conversion से होती है। आप app में अपना repository connect करते हैं और मौजूदा hardcoded strings एक ही pass में keys और locale files में extract हो जाती हैं। इसके बाद agent skills Cursor और Claude Code जैसे coding agents को शुरुआत से keyed strings लिखने देती हैं, hardcoding नहीं; और push jobs नए catalog units आते ही उनका translation कर देती हैं।
महत्वपूर्ण शब्द है—once। Conversion कठिन हिस्सा है और यह केवल एक बार होता है। इसके बाद वही काम चलता है जो पहले manual था, code की ही clock पर—और यही वजह है कि उसे code के बगल में रखने के बजाय developer workflow में रखा जाता है।
Runtime libraries पर कोई असर नहीं पड़ता। i18next और next-intl पहले की तरह locale files पढ़ते रहते हैं। Translations serve करने का तरीका नहीं बदलता। बदलता सिर्फ यह है कि files कौन लिखता है।
आप drift और वास्तविक translation problem में अंतर कैसे करेंगे?
पूछिए कि क्या किसी translator ने कभी वह string देखी थी।
अगर German file में कोई key गायब है, तो किसी translator से गलती नहीं हुई। String कभी किसी translator तक पहुँची ही नहीं। यह routing failure है, और review steps जोड़ने से समस्या और बढ़ती है, क्योंकि पहले से latency से जूझ रही process में queue time और जुड़ जाता है।
अगर German file में key मौजूद है, लेकिन context के लिए wording गलत है, तो यह वास्तविक translation problem है। इसके लिए ऐसे इंसान का समय देना उचित है जो German जानता हो और देख सके कि string render होकर कहाँ दिखाई देती है।
अधिकांश teams में दूसरी समस्या की तुलना में पहली समस्या कहीं ज़्यादा होती है, फिर भी वे दोनों को एक ही समस्या मानती हैं—इसीलिए localization अंतहीन लगती है। दोनों को अलग कीजिए और workload घट जाएगा, क्योंकि routing वाला हिस्सा पूरी तरह human work रह ही नहीं जाएगा। Team जितनी छोटी होगी, यह अंतर उतना ही महत्वपूर्ण होगा—इसीलिए यह तेज़ी से ship करने वाले solo developers और small teams के लिए सबसे स्पष्ट दिखता है।
एक उपयोगी test है: अपनी पिछली दस localization bugs में गिनिए कि कितनी गलत words थीं और कितनी missing words। अगर ज़्यादातर missing थीं, तो आपके पास translation problem नहीं है। आपके पास plumbing problem है—और plumbing को automate किया जा सकता है, judgment को नहीं। यही logic यह तय करते समय भी लागू होता है कि localization पर वास्तव में आपकी लागत कितनी होनी चाहिए।
Locale file drift, translation problem का रूप धारण किए हुए routing problem है। Repository को एक बार connect कीजिए और routing आपकी ज़िम्मेदारी नहीं रहेगी।
globalize.now आपके ऐप्लिकेशन की हार्डकोडेड कॉपी को अनुवाद-तैयार locale फ़ाइलों में बदल देता है और जैसे-जैसे आप नई रिलीज़ करते हैं, उन्हें अपडेट रखता है।
globalize.now को निःशुल्क आजमाएं